N2004: EVALAI – Hệ thống kiểm chứng và định lượng ảo giác AI trong y tế số Việt Nam

Việc ứng dụng AI tạo sinh trong lĩnh vực y tế tại Việt Nam ngày càng phổ biến, nhưng tiềm ẩn nguy cơ cung cấp thông tin sai lệch, trích dẫn tài liệu không có thật và tạo ra các chi tiết lâm sàng thiếu căn cứ. Trong khi đó, các bộ dữ liệu đánh giá AI y tế hiện có chủ yếu tập trung vào hỏi – đáp, chưa có công cụ kiểm chứng từng mệnh đề trong nội dung AI tạo ra dựa trên phác đồ của Bộ Y tế, danh mục thuốc BHYT và văn bản pháp luật còn hiệu lực. Trước yêu cầu ngày càng cao về quản trị rủi ro và tuân thủ pháp luật, việc xây dựng một phương pháp đánh giá có tính hệ thống, khách quan và có thể tái lập là cần thiết, giúp các cơ sở y tế kiểm chứng độ tin cậy của AI và chứng minh việc kiểm soát rủi ro trong quá trình triển khai.
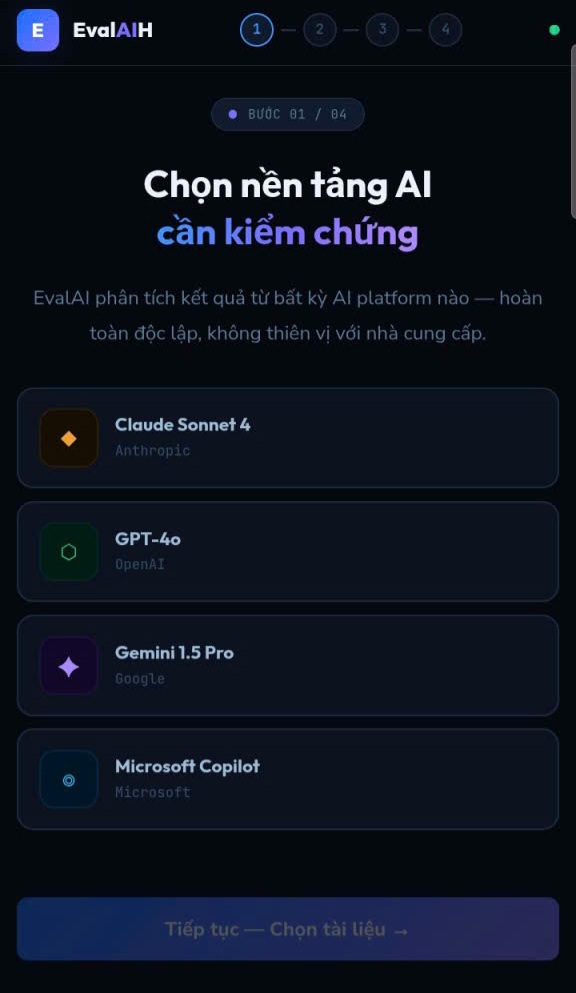
EvalAI là lớp kiểm chứng độc lập đặt giữa đầu ra AI và người ra quyết định. Hệ thống không tạo nội dung mới, chỉ tách văn bản thành các claim, đối chiếu từng claim với nguồn chuẩn có phiên bản và chấm điểm định lượng.
Một lớp kiểm chứng độc lập, không phải một chatbot mới
Điểm khác biệt đầu tiên của EvalAI nằm ở vai trò. Thị trường đang đầy những sản phẩm hứa hẹn "AI y tế chính xác hơn". EvalAI không cạnh tranh ở đó. Hệ thống không tạo nội dung mới; nó đứng giữa đầu ra AI và người ra quyết định, kiểm tra đầu ra của bất kỳ nền tảng nào – ChatGPT, Claude, Gemini, Copilot hay một hệ thống AI bất kỳ do bệnh viện tự xây. Cách đặt vấn đề này tương tự vai trò của phòng xét nghiệm độc lập hay kiểm toán tài chính: giá trị nằm ở chỗ không phụ thuộc vào bên bị kiểm tra.
Kiểm chứng ở mức từng mệnh đề. Một câu trả lời 300 chữ có thể chứa 5–6 mệnh đề có thể kiểm chứng: một liều thuốc, một con số dịch tễ, một trích dẫn, một điều luật. EvalAI tách văn bản thành từng mệnh đề (dùng PhoBERT cho tiếng Việt và BioBERT cho tiếng Anh), phân loại thành sáu nhóm (dữ kiện, thống kê, lâm sàng, trích dẫn, pháp lý, thị trường) rồi chuyển mỗi nhóm tới tác tử kiểm chứng chuyên trách. Người dùng nhận được không chỉ một điểm tổng, mà biết cụ thể mệnh đề nào sai, sai theo kiểu gì, đối chiếu với nguồn nào.
Phân loại 5 kiểu ảo giác đặc thù y tế Việt Nam. Từ phân tích đầu ra AI tiếng Việt thực tế, nhóm tác giả xây dựng phân loại H1–H5:
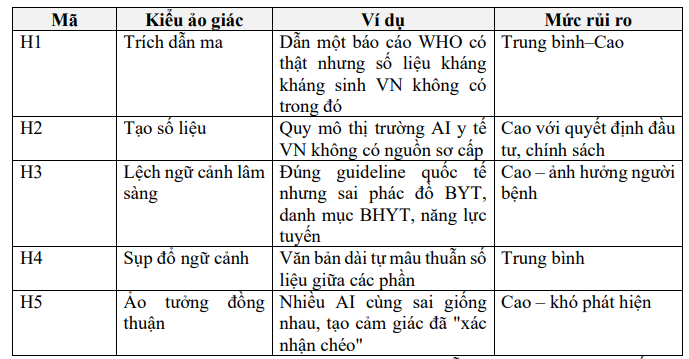
H3 và H5 là hai đóng góp đáng chú ý. H3 gọi tên một loại lỗi mà các bộ đánh giá quốc tế không thấy: câu trả lời đúng kiến thức y khoa nhưng sai với thực tế Việt Nam. H5 là lý do EvalAI từ chối dùng "nhiều AI cùng nói giống nhau" làm bằng chứng đúng – một thói quen phổ biến của người dùng.
Thang điểm MPVS với quy tắc chặn an toàn. MPVS (Multi-Perspective Verification Score) tổng hợp sáu chiều thành điểm 0–100: đúng y khoa (30%), logic lâm sàng (25%), tính toàn vẹn nguồn (20%), phù hợp pháp lý Việt Nam (15%), hợp lý thống kê (7%) và nhất quán nội bộ (3%). Trọng số được cố định trước khi chấm để tránh điều chỉnh hậu nghiệm. Điểm sáng tạo nằm ở hai quy tắc chặn bất biến: nếu phát hiện lỗi an toàn nghiêm trọng (sai liều có ý nghĩa lâm sàng, bỏ sót chống chỉ định tuyệt đối, sai xử trí cấp cứu), kết quả bị xếp REJECT bất kể các chiều khác cao đến đâu; nếu phát hiện mâu thuẫn logic nghiêm trọng, kết quả chỉ được phát hành sau khi chuyên gia duyệt. Một câu trả lời "95% đúng" nhưng sai liều insulin không được phép đạt điểm khá. Kho tri thức có phiên bản theo thời điểm hiệu lực. Mỗi nguồn trong kho – từ phác đồ BYT, danh mục BHYT đến Luật 134/2025/QH15 – được gắn nhãn thời điểm hiệu lực. Nhờ vậy, EvalAI phát hiện được loại lỗi "đúng ở thời điểm khác", ví dụ vẫn coi Nghị định 13/2023/NĐ-CP là căn cứ chính về bảo vệ dữ liệu cá nhân sau ngày 01/01/2026, khi Luật 91/2025/QH15 và Nghị định 356/2025/NĐ-CP đã có hiệu lực.
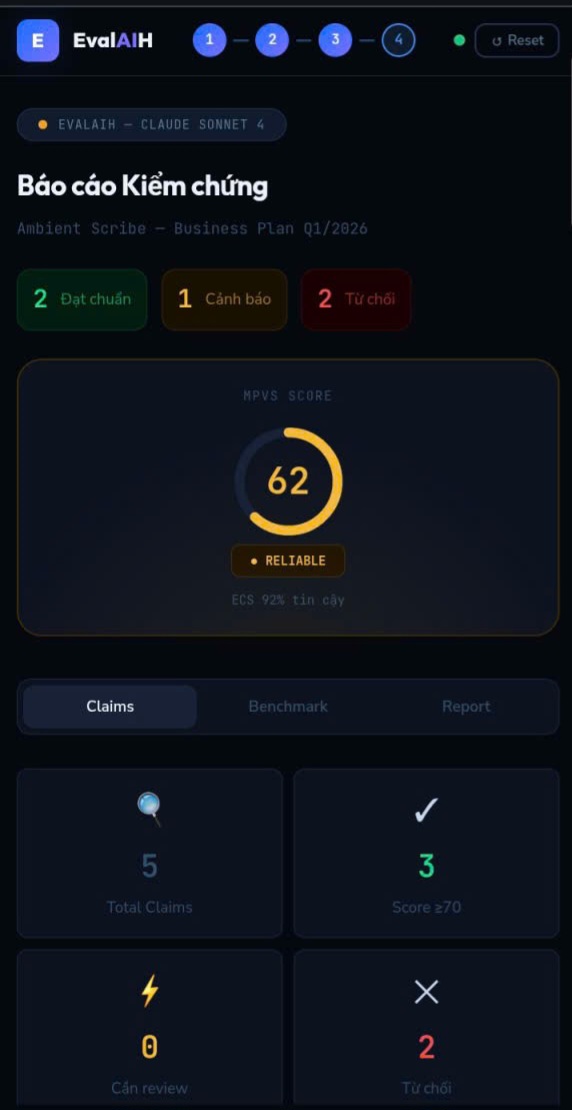
Hệ thống biết mình không chắc chắn ở đâu. Chỉ số ECS (Evaluator Confidence Score) là xác suất EvalAI tự ước lượng rằng phán định của chính nó đúng. Theo thiết kế, ECS cao (90–98%) với mệnh đề có DOI/PMID xác minh trực tiếp, và thấp (30– 65%) với số liệu thị trường, dược động học đặc thù người Việt hay văn bản pháp luật mới ban hành dưới 6 tháng. Mọi mệnh đề có ECS dưới 70% bắt buộc chuyển chuyên gia. Một công cụ kiểm chứng tự công bố giới hạn của mình là điều hiếm gặp, và cũng là điều kiện để không tạo ra một lớp "thiên kiến tự động hóa" mới.
Từ đánh giá một câu trả lời đến đánh giá một hệ thống. Bên cạnh MPVS, EvalAI đề xuất khung 12 trụ cột "Medical AI Readiness" tổng hợp từ WHO, NIST AI RMF, IMDRF SaMD và ISO/IEC 42001 – từ mục đích sử dụng, an toàn lâm sàng, công bằng đến khả năng tích hợp HIS/FHIR và sẵn sàng pháp lý – cùng lộ trình trưởng thành bảy cấp L0–L6, từ "công cụ kiểm tra nội dung" đến "sẵn sàng trở thành phần mềm là thiết bị y tế (SaMD)". Đây là công cụ để bệnh viện đặt câu hỏi đúng trước khi mua sắm một giải pháp AI.
Theo hiểu biết của tác giả tại thời điểm viết, chưa có công cụ công bố nào tại Việt Nam kết hợp đồng thời bốn yếu tố: kiểm chứng mức mệnh đề, truy vết nguồn, quy tắc chặn an toàn và chiều phù hợp pháp lý Việt Nam. So với các khung quốc tế như MedHELM (Stanford) hay CREOLA, EvalAI bổ sung lớp ngữ cảnh Việt Nam và cơ chế phiên bản theo thời gian.
Những gì đã đo được và những gì còn phải chứng minh
Kết quả benchmark Giai đoạn 1. Trong quý IV/2025, nhóm dự án chạy EvalAI trên khoảng 200 trường hợp kiểm thử nội bộ, gồm tra cứu phác đồ, tóm tắt tài liệu, thông tin và tương tác thuốc, câu hỏi pháp lý y tế số và trích dẫn y văn, với bốn nền tảng AI phổ dụng lúc đó. Kết quả: cả bốn – Claude Sonnet 4 (67/100), GPT-4o (63), Gemini 1.5 Pro (63) và Copilot (58) – đều nằm trong vùng CONDITIONAL, tức chỉ dùng được sau khi chuyên gia duyệt sâu, không dùng cho quyết định lâm sàng tự động.
Phát hiện quan trọng hơn thứ hạng là cấu trúc điểm. Ở cả bốn nền tảng, thứ tự các chiều giống hệt nhau: đúng y khoa > logic lâm sàng > toàn vẹn nguồn > phù hợp pháp lý Việt Nam. Chiều pháp lý thấp nhất xuyên suốt, chỉ 50–61/100. Điều này cho thấy điểm yếu không nằm ở một mô hình cụ thể mà nằm ở loại tri thức: văn bản pháp luật Việt Nam về AI, dữ liệu và y tế số thay đổi nhanh trong 2025–2026 và nằm ngoài hoặc sát mốc dữ liệu huấn luyện của các mô hình. Logic lâm sàng thấp hơn đúng y khoa ở cả bốn nền tảng – biểu hiện định lượng của hiện tượng H3: biết y khoa chung nhưng không khớp phác đồ Bộ Y tế, danh mục BHYT hay năng lực tuyến. Kết quả này nhất quán với MedHELM, nơi hiệu năng thấp nhất cũng rơi vào nhóm hỗ trợ quyết định lâm sàng. Ý nghĩa thực tiễn rất cụ thể: một bác sĩ hỏi AI về quy định bảo vệ dữ liệu người bệnh, hay về thuốc nào được BHYT thanh toán, đang hỏi đúng vào vùng mà AI yếu nhất. EvalAI chỉ ra được điều đó bằng con số, thay vì cảm nhận.
Giới hạn của kết quả hiện có. Nhóm dự án có thể nói rằng: đây là benchmark thăm dò nội bộ, chưa chấm mù bởi chuyên gia độc lập, chưa có khoảng tin cậy. Chênh lệch 9 điểm giữa nền tảng cao nhất và thấp nhất chưa đủ để khẳng định thứ hạng. Các mô hình AI đã ra phiên bản mới sau Q4/2025, nên con số không đại diện cho phiên bản hiện hành. EvalAI hiện chưa được triển khai tại cơ sở khám chữa bệnh nào, nên chưa có số liệu hiệu quả vận hành hay xác nhận của đơn vị áp dụng. Hiện tác giả tham gia dự án dưới dạng bài trình bày khoa học tại HEALTHINFO IV - diễn đàn học thuật quốc tế do Hội Kinh tế Y tế Việt Nam (VHEA) khởi xướng và được tổ chức với sự phối hợp của các trường đại học, bệnh viện, cơ sở y tế cùng các đối tác quốc tế; chấp nhận Full paper của Ban tổ chức chương trình AI4HEALTH 2026 do Đại học Y Dược- Đại học Quốc Gia Hà Nội tổ chức
Thiết kế để chứng minh hiệu quả ở Giai đoạn 2. Thay vì tự công bố hiệu quả, dự án xây dựng sẵn một nghiên cứu POC đủ chặt để bị bác bỏ:
− ≥1.000 trường hợp chia tám miền: phác đồ BYT (150), thuốc và danh mục BHYT (150), tóm tắt hồ sơ trên dữ liệu giả lập (125), trích dẫn y văn (125), số liệu dịch tễ Việt Nam (125), pháp lý y tế số (125), mã hóa ICD-10 và thanh toán BHYT (50), tình huống đối kháng với tiền đề sai (150).
− Hai chuyên gia gán nhãn độc lập từng mệnh đề, không biết tên mô hình và không biết nhãn của EvalAI; chuyên gia thứ ba phân xử; EvalAI chạy trước khi có nhãn chuyên gia.
− Tiêu chí Go/No-Go định trước: độ nhạy ≥90% với mệnh đề sai và ≥95% với lỗi an toàn nghiêm trọng; độ đặc hiệu ≥85%; tỷ lệ bỏ sót lỗi nghiêm trọng ≤2%; sai số hiệu chuẩn ECS ≤0,10; giảm ≥30% thời gian rà soát.
− Thiết kế chéo: người duyệt rà soát một nửa số ca thủ công, một nửa có EvalAI hỗ trợ, rồi đổi điều kiện. Nếu thời gian giảm nhưng người duyệt bỏ qua lỗi mà EvalAI không gắn cờ, kết quả được coi là dấu hiệu thiên kiến tự động hóa, không phải hiệu quả.
− Báo cáo theo chuẩn quốc tế TRIPOD-LLM và CHART; tỷ lệ kèm khoảng tin cậy 95% Wilson. Cỡ mẫu ước tính 16.000–24.000 mệnh đề, vượt xa mức tối thiểu khoảng 385 mệnh đề sai cần cho ước lượng độ nhạy 90% ±3%.
Hiệu quả xã hội kỳ vọng. Người thụ hưởng trực tiếp là bác sĩ, dược sĩ, nhân viên y tế đang dùng AI hằng ngày; bộ phận quản lý chất lượng, CNTT và pháp chế bệnh viện cần bằng chứng quản trị rủi ro AI; nhà cung cấp giải pháp AI cần chứng minh chất lượng sản phẩm; và cơ quan quản lý cần một chuẩn đo tham chiếu. Người thụ hưởng cuối cùng là người bệnh, ít bị ảnh hưởng bởi một lời khuyên sai được AI nói ra rất tự tin. Những tác động này sẽ chỉ được lượng hóa sau POC.
Mức độ nhân rộng và lan tỏa
Không phụ thuộc nền tảng, không phụ thuộc địa bàn. Vì EvalAI chỉ nhận văn bản đầu ra, mọi cơ sở đang dùng bất kỳ AI nào đều có thể áp dụng mà không phải thay đổi hạ tầng. Hệ thống nhận text, DOCX, PDF, JSON, bản tin HL7 FHIR R4 và cả âm thanh, xuất kết quả dưới dạng gói FHIR R4 để tích hợp vào hệ thống thông tin bệnh viện (HIS).
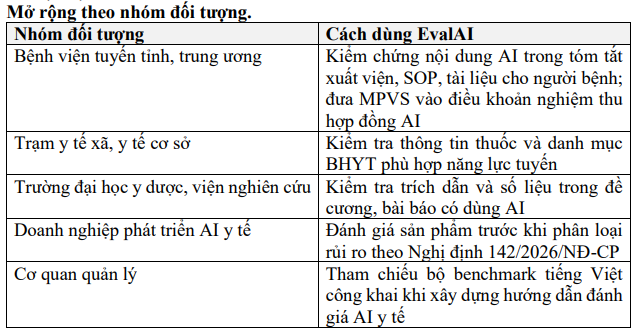
Lan tỏa qua chuẩn mở. Dự án cam kết công bố benchmark mở "Ảo giác AI trong Y tế số Việt Nam 2026" sau POC, để các bệnh viện, trường đại học và doanh nghiệp khác tái lập, so sánh và góp thêm dữ liệu. Một chuẩn đo dùng chung có sức lan tỏa lớn hơn một sản phẩm đóng. Bên cạnh đó, tác giả đã xây dựng cẩm nang ứng dụng AI trong y tế cho bác sĩ và nhân viên y tế, giúp nâng nhận thức về rủi ro ảo giác ngay từ người dùng.
Mở rộng ra ngoài Việt Nam. Kiến trúc tách lớp tri thức quốc tế (WHO, PubMed, ICD, SNOMED CT, LOINC) khỏi lớp tri thức quốc gia (phác đồ, danh mục thuốc, pháp luật). Muốn áp dụng cho Lào, Campuchia hay quốc gia ASEAN khác, chỉ cần thay lớp tri thức quốc gia và hiệu chỉnh chiều pháp lý C4, phần lõi giữ nguyên.
Năng lực thực hiện, tính bền vững và quản trị rủi ro
Năng lực thực hiện. Dự án được phát triển bởi các nhân sự đến từ chuyên gia Y tế, chuyên gia Khoa học dữ liệu, học máy phát triển, dưới sự dẫn dắt của tác giả Vũ Hoàng Thương, nhà nghiên cứu y tế số có nền tảng khoa học máy tính. Tác giả đã có kinh nghiệm xây dựng các giải pháp dựa trên dữ liệu y tế chuẩn hóa HL7 FHIR, và ứng dụng hệ sinh thái y tế số. Các thành phần kỹ thuật của EvalAI – điều phối đa tác tử bằng LangGraph, cơ sở dữ liệu vector Qdrant, PhoBERT/BioBERT, Whisper chạy cục bộ – đều là công nghệ đã trưởng thành, giảm rủi ro kỹ thuật. Bản MVP đang được hoàn thiện; giải pháp đang đăng ký quyền tác giả tại Cục Bản quyền tác giả.
Tính bền vững. Nhu cầu về EvalAI không phải nhu cầu nhất thời. Khi Luật 134/2025/QH15 và Nghị định 142/2026/NĐ-CP đi vào thực thi, mọi bên cung cấp và triển khai AI y tế đều cần bằng chứng quản trị rủi ro định kỳ, và mỗi lần mô hình AI cập nhật phiên bản lại cần tái kiểm định. Dự án triển khai theo lộ trình rủi ro: hiện ở cấp L1–L2 (kiểm tra nội dung y tế và tri thức lâm sàng), áp dụng trước cho tác vụ rủi ro thấp–trung bình (nghiên cứu, đề cương, nội dung cho người bệnh, SOP), chỉ tiến lên L4 trở lên khi có bằng chứng POC và hệ thống quản lý chất lượng. Khi EvalAI được tích hợp trực tiếp vào quyết định lâm sàng, hệ thống sẽ được phân loại lại theo Nghị định 142/2026/NĐ-CP và khung IMDRF. Mô-đun dự báo ảo giác dựa trên kiến trúc JEPA được thiết kế cho giai đoạn sau, nhằm giảm phụ thuộc vào cơ chế "AI chấm AI". Quản trị rủi ro. Dự án nhận diện và công bố các rủi ro của chính mình:
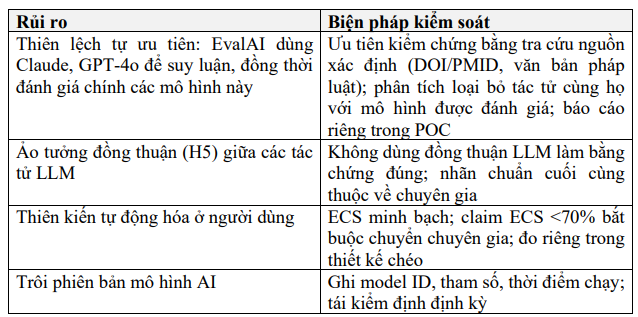
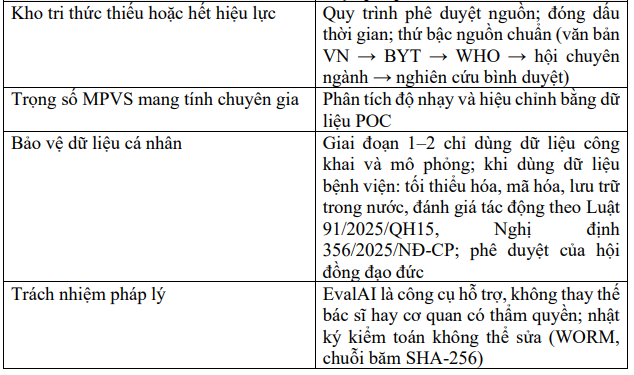
EvalAI không hứa hẹn một AI y tế không bao giờ sai. Nó hứa hẹn một điều thực tế hơn: biết AI đang sai bao nhiêu, sai ở đâu và sai có nguy hiểm không – trong ngữ cảnh phác đồ, danh mục thuốc và pháp luật Việt Nam. Kết quả bước đầu đã cho thấy các AI phổ dụng đều chỉ ở mức "có điều kiện" với nội dung y tế tiếng Việt, yếu nhất ở pháp lý. Bước tiếp theo cần chứng minh không phải EvalAI "giỏi hơn" ChatGPT hay Gemini, mà là EvalAI phát hiện được lỗi của chúng với độ nhạy đủ cao, hiệu chuẩn được sự không chắc chắn của chính mình, và giúp người duyệt nhanh hơn mà không chủ quan hơn.
AI y tế chỉ đáng tin khi đo được mức độ "không đáng tin" của nó.
Danh mục tài liệu, hình ảnh minh chứng:
✓ Hiện giải pháp đang đăng ký hồ sơ Bản quyền Tại Cục Bản quyền tác giả có mã hồ sơ: G16.15-260619-G160049, dự kiến trả kết quả vào ngày 10 tháng 11 năm 2026.
✓ Đã có bản thử nghiệm Pilot cho 01 nhóm nhỏ các bác sĩ, chuyên gia y tế dùng đánh giá, góp ý để tác giả ghi nhận và cập nhật giải pháp.
Vũ Hoàng Thương